


Deepseek, el laboratorio chino de IA que recientemente devolvió los supuestos de la industria sobre los costos de desarrollo del sector, ha lanzado una nueva familia de modelos de IA multimodales de código abierto que, según los informes, superan a Dall-E 3 de OpenAi en los puntos de referencia clave. Divedió Janus Pro, el modelo varía de mil millones de miles de millones (extremadamente pequeño) a 7 mil millones de parámetros (cerca del tamaño de SD 3.5L) y está disponible para la descarga inmediata de Aprendizaje automático y Data Science Hub Hubface. La versión más grande, Janus Pro 7B, vence no solo a Dall-E 3 de OpenAi sino también Otros modelos principales como Pixart-Alpha, EMU3-Gen y SDXL en los puntos de referencia de la industria Gineval y DPG-Bench, según la información compartida por Deepseek AI.Imagen: Deepseek Aiits El lanzamiento llega pocos días después de que Deepseek llegó a los titulares con su modelo de idioma R1, que coincidió con las capacidades de GPT-4, al tiempo que costó solo $ 5 millones para desarrollarse, emprendiendo un acalorado debate sobre el estado actual de la industria de la IA. El producto de la startup china tiene También desencadenó las preocupaciones en todo el sector que podría volcar a los titulares y eliminar la trayectoria de crecimiento del principal fabricante de chips Nvidia, que sufrió la mayor pérdida de capitalización de mercado de un solo día en la historia el lunes. «Eso desacopla la codificación visual en vías separadas mientras se mantiene una sola arquitectura de transformador unificada. Este diseño permite que el modelo analice las imágenes y genere imágenes a la resolución 768×768». Janus Pro supera el modelo y las coincidencias anteriores o excede el rendimiento de la tarea específico de la tarea Modelos «, afirmó Deepseek en su documentación de lanzamiento. «La simplicidad, la alta flexibilidad y la efectividad de Janus Pro lo convierten en un fuerte candidato para los modelos multimodales unificados de próxima generación». A diferencia de Deepseek R1, la compañía no publicó un documento técnico completo en el modelo, pero lanzó su documentación técnica y Hizo que el modelo esté disponible para una descarga inmediata de forma gratuita, lo que continúa su práctica de lanzamientos de emisión abierta que contrasta bruscamente con el enfoque cerrado y patentado de los gigantes tecnológicos estadounidenses. Entonces, ¿cuál es nuestro veredicto? Bueno, el modelo es muy versátil. Sin embargo, no espere que reemplace cualquiera de los modelos más especializados que ame. Puede generar texto, analizar imágenes y generar fotos, pero cuando se enfrenta a modelos que solo hacen una de esas cosas bien, en el mejor de los casos, está a la par.
Probar el modelo
Tenga en cuenta que no hay una forma inmediata de usar UI tradicionales para ejecutarlo: comparación, A1111, enfoque y dibujar las cosas no son compatibles con ella en este momento. Esto significa que no es práctico ejecutar el modelo localmente y requiere pasar por comandos de texto en un terminal. Sin embargo, algunos usuarios de Hugginface han creado espacios para probar el modelo. El espacio oficial de Deepseek no está disponible, por lo que recomendamos usar el espacio libre de Neurosenko para probar Janus 7b. Sea consciente de lo que hace, ya que algunos títulos pueden ser engañosos. Por ejemplo, el espacio ejecutado por AP123 dice que ejecuta Janus Pro 7B, pero en cambio ejecuta Janus Pro 1.5b, lo que puede terminar haciendo que pierda mucho tiempo libre probando el modelo y obteniendo malos resultados. Confíe en nosotros: lo sabemos porque nos sucedió. Comprensión visual El modelo es bueno para la comprensión visual y puede describir con precisión los elementos en una foto. Mostró una buena conciencia espacial y la relación entre diferentes objetos. También es más preciso que Llava— El modelo de visión de código abierto más popular: ser capaz de proporcionar descripciones más precisas de escenas e interactuar con el usuario en función de las indicaciones visuales. Sin embargo, todavía no es mejor que la visión GPT, especialmente para las tareas que requieren lógica o algún análisis más allá de lo que obviamente se muestra en la foto. Por ejemplo, le pedimos al modelo que analizara esta foto y explicara su mensaje.
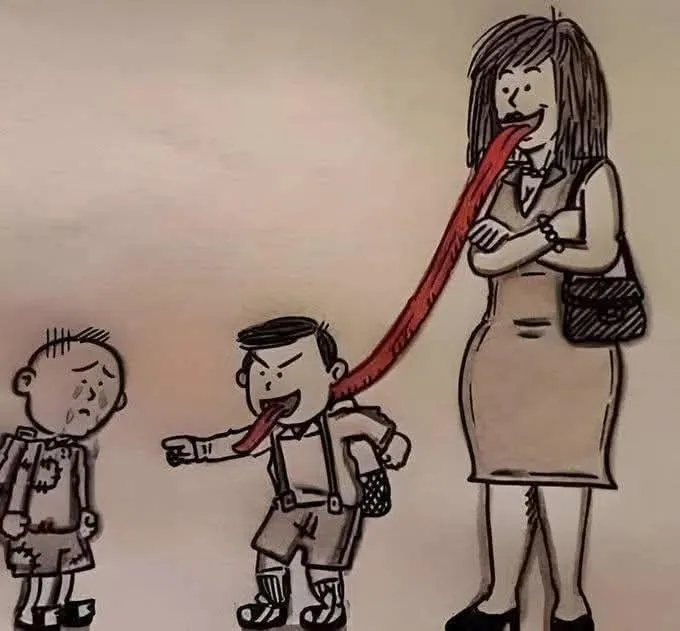 El modelo respondió: «La imagen parece ser una caricatura humorística que representa una escena en la que una mujer está lamiendo el final de una lengua roja larga que está unida a un niño». Terminó su análisis al decir que «el tono general de la imagen Parece ser alegre y juguetón, posiblemente sugiriendo un escenario en el que la mujer se involucre en un acto travieso o burlón «.
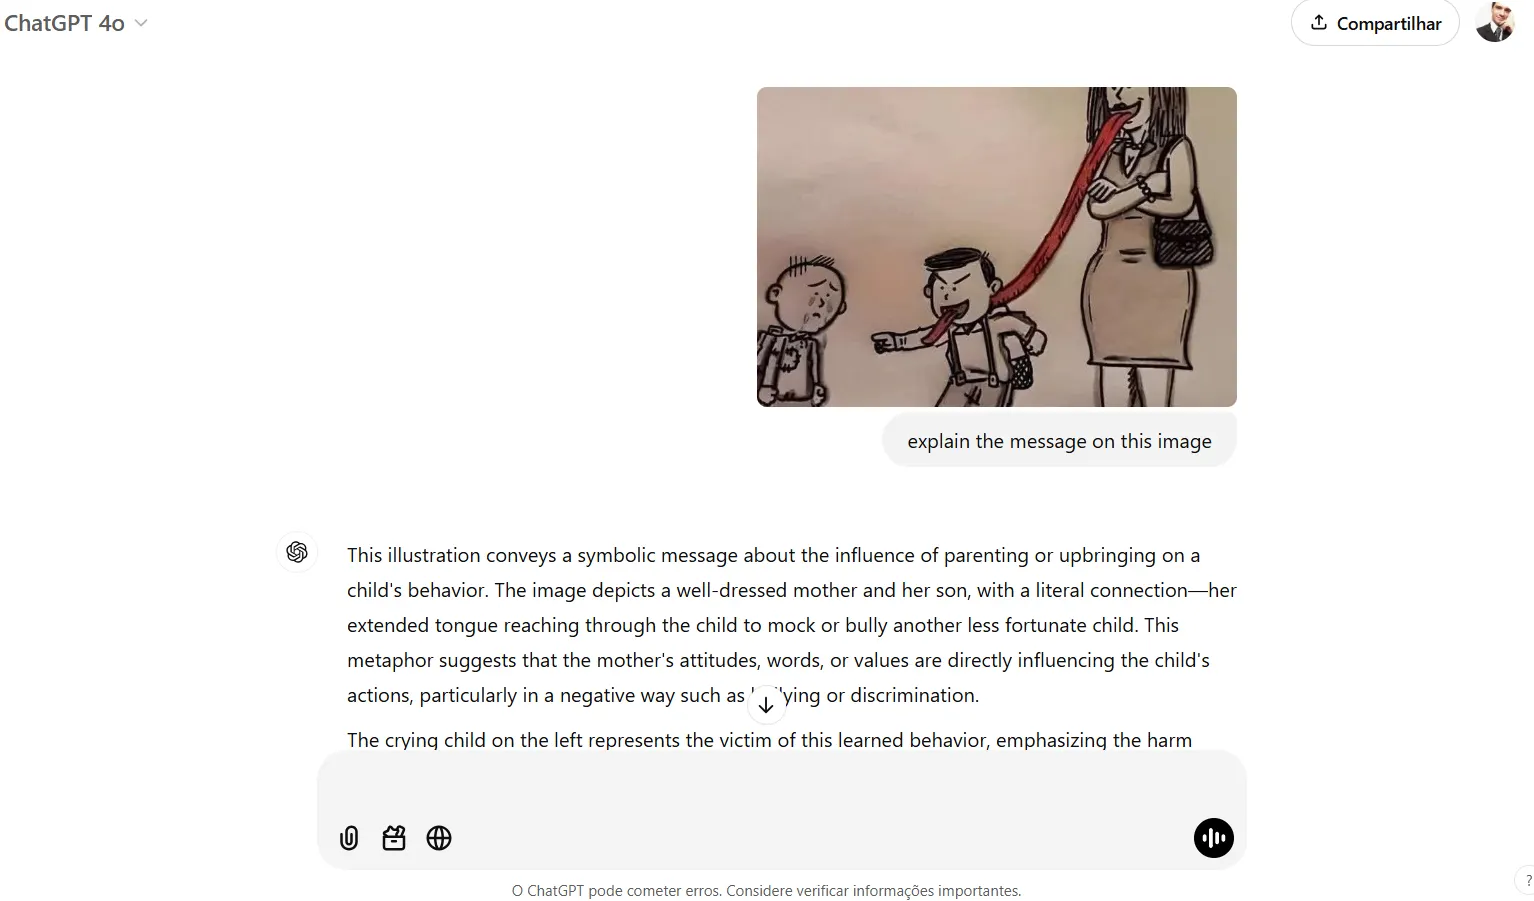
 En estas situaciones en las que se requiere algún razonamiento más allá de una simple descripción, el modelo falla la mayor parte del tiempo. Por otro lado, Chatgpt, por ejemplo, realmente entendió el significado detrás de la imagen: “Esta metáfora sugiere que las actitudes, las palabras, las palabras, las palabras, las palabras, o los valores influyen directamente en las acciones del niño, particularmente de manera negativa, como el acoso o la discriminación «, concluyó, con precisión, agregaremos.
 Una liga de su propia generación de imagen parece robusta y relativamente precisa, aunque requiere una impulso cuidadoso para lograr buenos resultados. Deadeek afirma que Janus Pro vence a SD 1.5, SDXL y Pixart Alpha, pero es importante enfatizar esto debe ser una comparación contra la base , modelos no ajustados. En otras palabras, la comparación justa es entre las peores versiones de los modelos disponibles actualmente, ya que, posiblemente, nadie usa una base SD 1.5 para generar arte cuando hay cientos de melodías finas capaces de lograr resultados que puedan Compite contra modelos de última generación como Flux o Stable Difusion 3.5. Por lo tanto, las generaciones no son impresionantes en términos de calidad, pero parecen mejores que lo que SD1.5 o SDXL solían producir cuando se lanzaron . Por ejemplo, aquí hay una comparación cara a cara de las imágenes generadas por Janus y SDXL para el aviso: un lindo y adorable zorro de bebé con grandes ojos marrones, hojas de otoño en el fondo encantadoras, inmortal, esponjosas y brillantes, Mane, brillante, Pétalos, hadas, altamente detallados, fotorrealistas, cinemátiles, colores naturales.
 Janus vence a SDXL al comprender el concepto central: podría generar un zorro bebé en lugar de un zorro maduro, como en el caso de SDXL. También entendió mejor el estilo fotorrealista, y los otros elementos (esponjosos, cinemáticos) también estaban presentes. Eso dijo. SDXL generó una imagen más nítida a pesar de no adherirse al mensaje. La calidad general es mejor, los ojos son realistas y los detalles son más fáciles de detectar. Este patrón fue consistente en otras generaciones: buena comprensión rápida pero mala ejecución, con imágenes borrosas que se sienten desactualizadas teniendo en cuenta el buen estado actual de Los generadores de imágenes de arte son. Sin embargo, es importante tener en cuenta que Janus es una LLM multimodal capaz de generar conversaciones de texto, analizar las imágenes y generarlas también. Flux, SDXL y los otros modelos no están construidos para esas tareas. Entonces, Janus es mucho más versátil en su núcleo, solo que no es excelente en nada en comparación con modelos especializados que sobresalen en una tarea específica. El futuro como líder entre los entusiastas generativos de la IA dependerá de una serie de actualizaciones que buscan mejorar esos puntos. Editado por Josh Quittner y Sebastian Sinclair
Boletín generalmente inteligente
Un viaje semanal de IA narrado por Gen, un modelo de IA generativo.