


La escena del arte de la IA está cada vez más caliente. Sana, un nuevo modelo de IA presentado por Nvidia, ejecuta la generación de imágenes 4K de alta calidad en hardware de consumo, gracias a una combinación inteligente de técnicas que difieren un poco de la forma en que funcionan los generadores de imágenes tradicionales. La velocidad de Sana proviene de lo que Nvidia llama “codificador automático de compresión profunda” que comprime los datos de la imagen hasta 1/32 de su tamaño original, manteniendo todos los detalles intactos. El modelo combina esto con Gemma 2 LLM para comprender las indicaciones, creando un sistema que supera con creces su categoría de peso en un hardware modesto. Si el producto final es tan bueno como la demostración pública, Sana promete ser un nuevo generador de imágenes creado para ejecutarse en sistemas menos exigentes, lo que será una gran ventaja para Nvidia a medida que intenta llegar a más usuarios. “Sana-0.6B es muy competitivo con el modelo de difusión gigante moderno (por ejemplo, Flux-12B), siendo 20 veces más pequeño y 100+ veces más rápido en rendimiento medido”, escribió el equipo de Nvidia en el artículo de investigación de Sana, “Además, Sana-0.6B se puede implementar en una GPU de computadora portátil de 16 GB, y tarda menos de 1 segundo en generar una imagen con resolución de 1024 × 1024”.Imagen: NvidiaSí, leíste bien: Sana es un modelo de 0,6 mil millones de parámetros que compite contra modelos 20 veces su tamaño, mientras genera imágenes 4 veces más grandes, en una fracción del tiempo. Si eso suena demasiado bueno para ser verdad, puedes probarlo tú mismo en una interfaz especial configurada por el MIT. El momento de Nvidia no podría ser más oportuno, con modelos como el recientemente presentado Stable Diffusion 3.5, el querido Flux y el nuevo Auraflow ya está luchando por llamar la atención. Nvidia planea publicar pronto su código como código abierto, una medida que podría solidificar su posición en el mundo del arte de la IA y, al mismo tiempo, aumentar las ventas de sus GPU y herramientas de software, digamos.
La Santísima Trinidad que hace que Sana sea tan buena.
Sana es básicamente una reinvención de la forma en que funcionan los generadores de imágenes tradicionales. Pero hay tres elementos clave que hacen que este modelo sea tan eficiente. En primer lugar, está el codificador automático de compresión profunda de Sana, que reduce los datos de la imagen a sólo un 3% de su tamaño original. Los investigadores dicen que esta compresión utiliza una técnica especializada que mantiene detalles intrincados al tiempo que reduce drásticamente la potencia de procesamiento necesaria. Puede considerar esto como un sustituto optimizado del codificador automático variable que se implementa en Flux o Stable Diffusion. El proceso de codificación/decodificación en Sana está diseñado para ser más rápido y eficiente. Estos codificadores automáticos básicamente traducen las representaciones latentes (lo que la IA entiende y genera) en imágenes. En segundo lugar, Nvidia revisó la forma en que su modelo maneja las indicaciones, que es mediante codificar y decodificar texto. La mayoría de las herramientas artísticas de IA utilizan codificadores de texto como T5 o CLIP para traducir básicamente el mensaje del usuario en algo que una IA pueda entender: representaciones latentes del texto. Pero Nvidia optó por utilizar Gemma 2 LLM de Google. Este modelo hace básicamente lo mismo, pero se mantiene liviano y al mismo tiempo capta matices en las indicaciones del usuario. Escriba «puesta de sol sobre montañas brumosas con ruinas antiguas» y obtendrá la imagen, literalmente, sin maximizar la memoria de su computadora. Pero el transformador de difusión lineal es probablemente la principal desviación de los modelos tradicionales. Mientras que otras herramientas de inteligencia artificial utilizan operaciones matemáticas complejas que obstaculizan el procesamiento, el LDT de Sana elimina cálculos innecesarios. ¿El resultado? Generación de imágenes ultrarrápida sin pérdida de calidad. Piense en ello como encontrar un atajo a través de un laberinto: el mismo destino, pero una ruta mucho más rápida. Esta podría ser una alternativa a la arquitectura UNet que los artistas de IA conocen por modelos como Flux o Stable Diffusion. UNet es lo que transforma el ruido (algo que no tiene sentido) en una imagen clara mediante la aplicación de técnicas de eliminación de ruido, refinando gradualmente la imagen a través de varios pasos: el proceso que consume más recursos en los generadores de imágenes. Entonces, el LDT en Sana esencialmente realiza las mismas tareas de “eliminación de ruido” y transformación que la UNet en Difusión Estable pero con un enfoque más ágil. Esto hace que LDT sea un factor crucial para lograr alta eficiencia y velocidad en la generación de imágenes de Sana, mientras que UNet sigue siendo fundamental para la funcionalidad de Stable Diffusion, aunque con mayores demandas computacionales.
Pruebas básicas
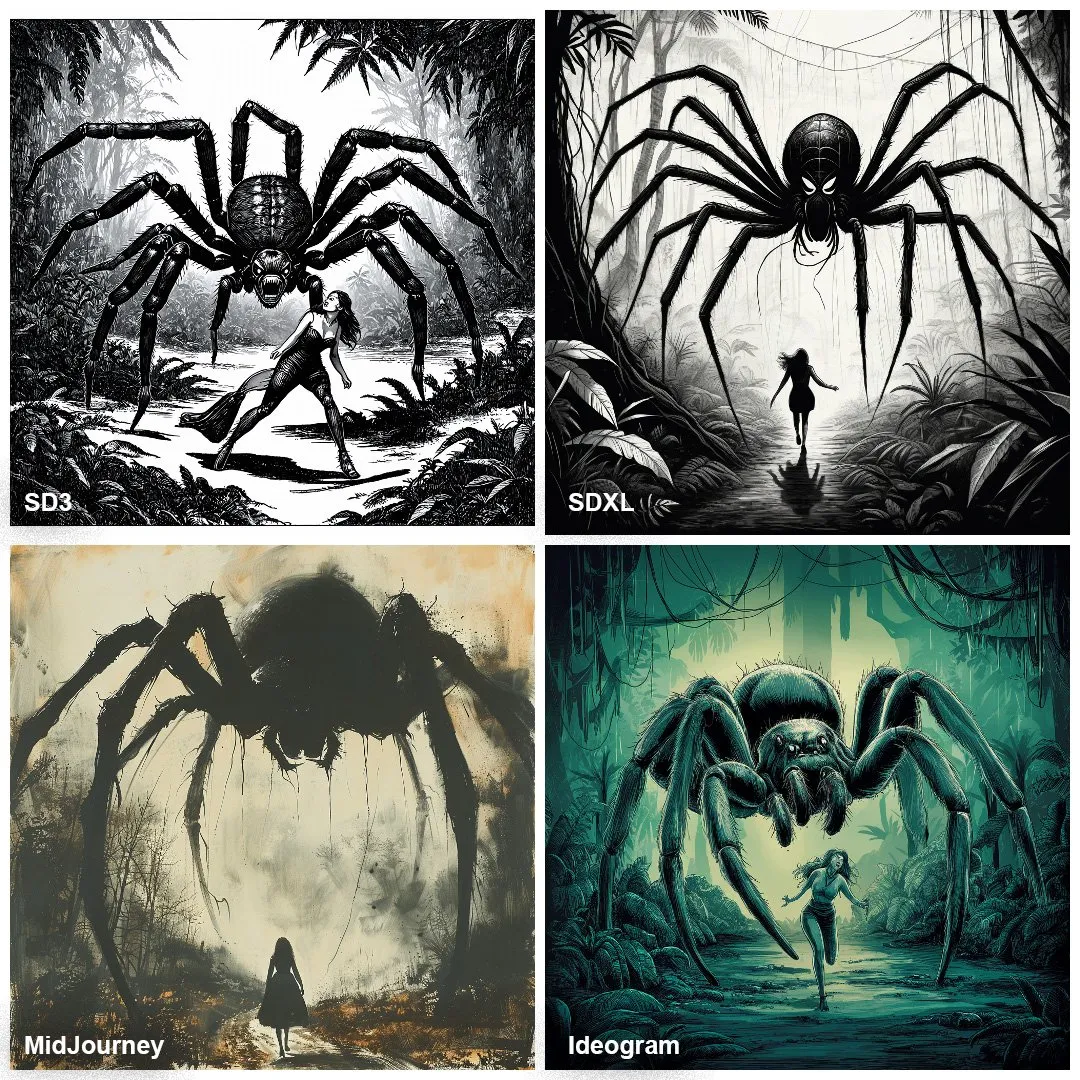
Dado que el modelo no se publica, no compartiremos una revisión detallada. Pero algunos de los resultados que obtuvimos en el sitio de demostración del modelo fueron bastante buenos. Sana demostró ser bastante rápida. A modo de comparación, pudo generar imágenes 4K, renderizando 30 pasos en menos de 10 segundos. Esto es incluso más rápido que el tiempo que le toma a Flux Schnell generar una imagen similar en 4 pasos con tamaños de 1080p. Aquí hay algunos resultados, usando las mismas indicaciones que usamos para comparar otros generadores de imágenes: Pregunta 1: “Ilustración dibujada a mano de un araña gigante persiguiendo a una mujer en la jungla, extremadamente aterrador, angustia, escenario oscuro y espeluznante, horror, indicios de influencia de fotografía analógica, boceto”.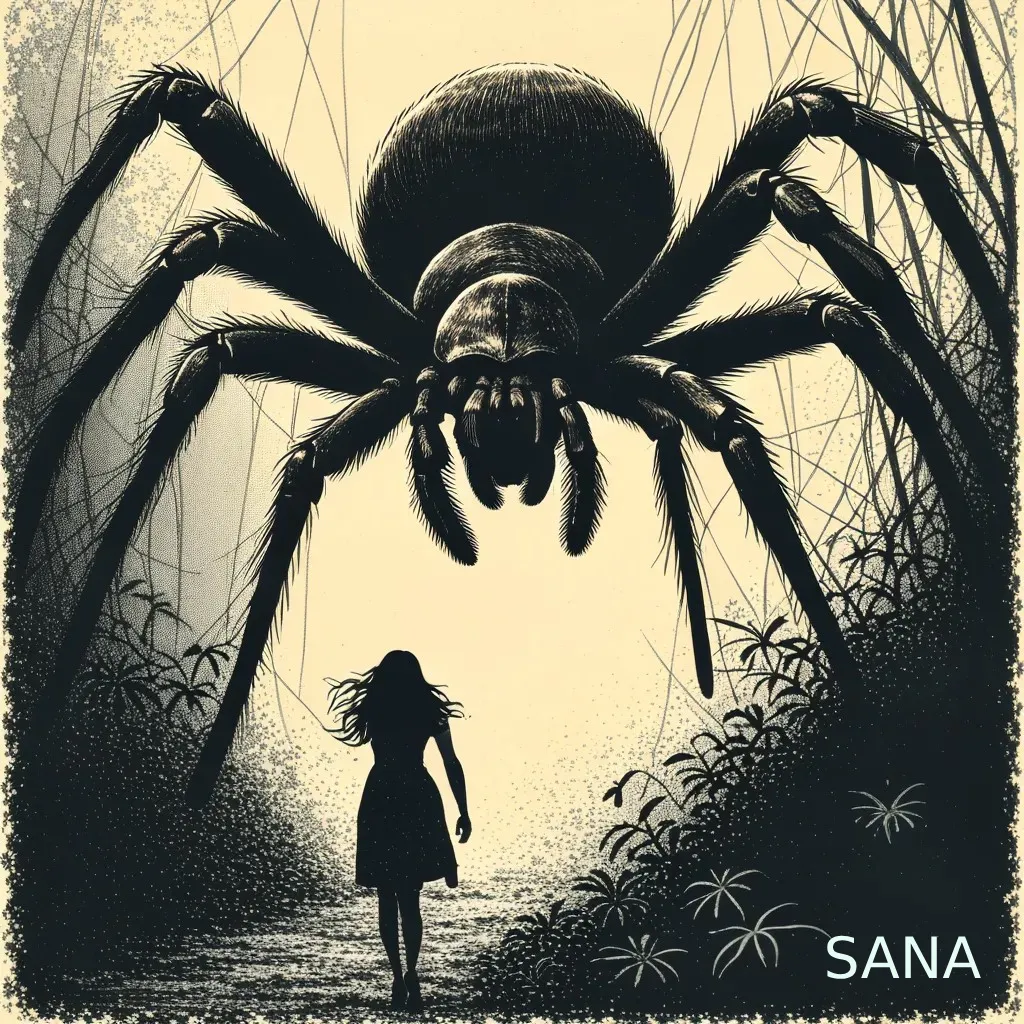
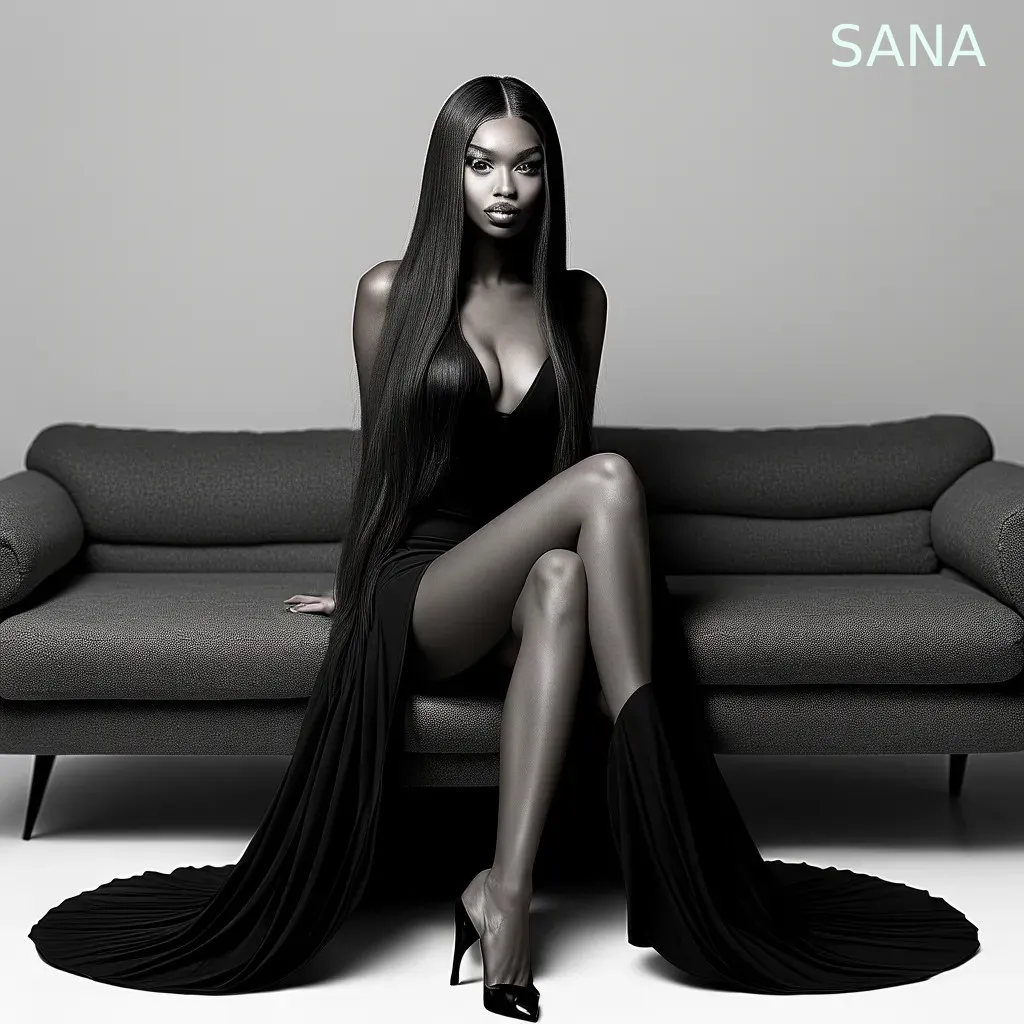
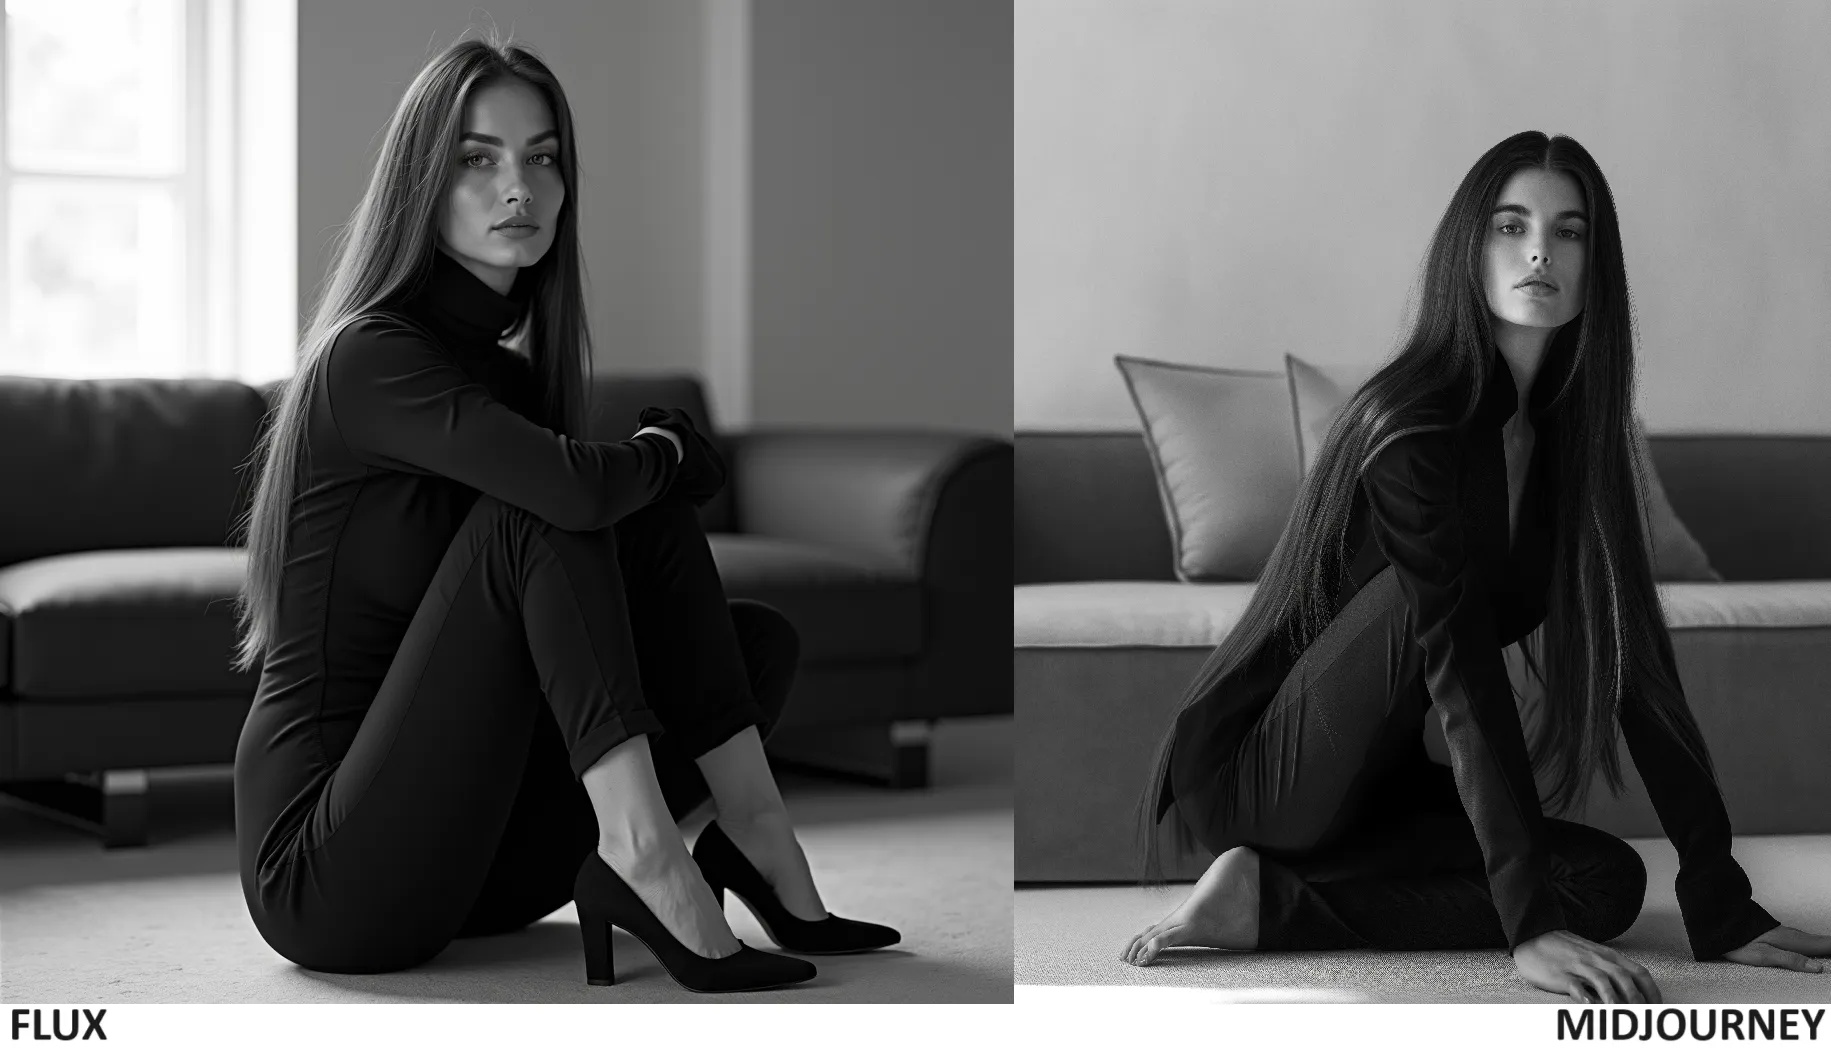
 Pregunta 2: Una fotografía en blanco y negro de una mujer con cabello largo y liso, vestida con un traje completamente negro que acentúa sus curvas, sentada en el suelo frente a un sofá moderno. Ella posa con confianza para la cámara, mostrando sus delgadas piernas mientras se agacha. El fondo presenta un diseño minimalista, enfatizando su pose elegante contra el marcado contraste entre las paredes de color gris claro y el atuendo oscuro. Su expresión rezuma confianza y sofisticación. Tomada por Peter Lindbergh con una lente Hasselblad X2D de 105 mm con una apertura de f/4. ISO 63. La gradación de color profesional mejora el atractivo visual.
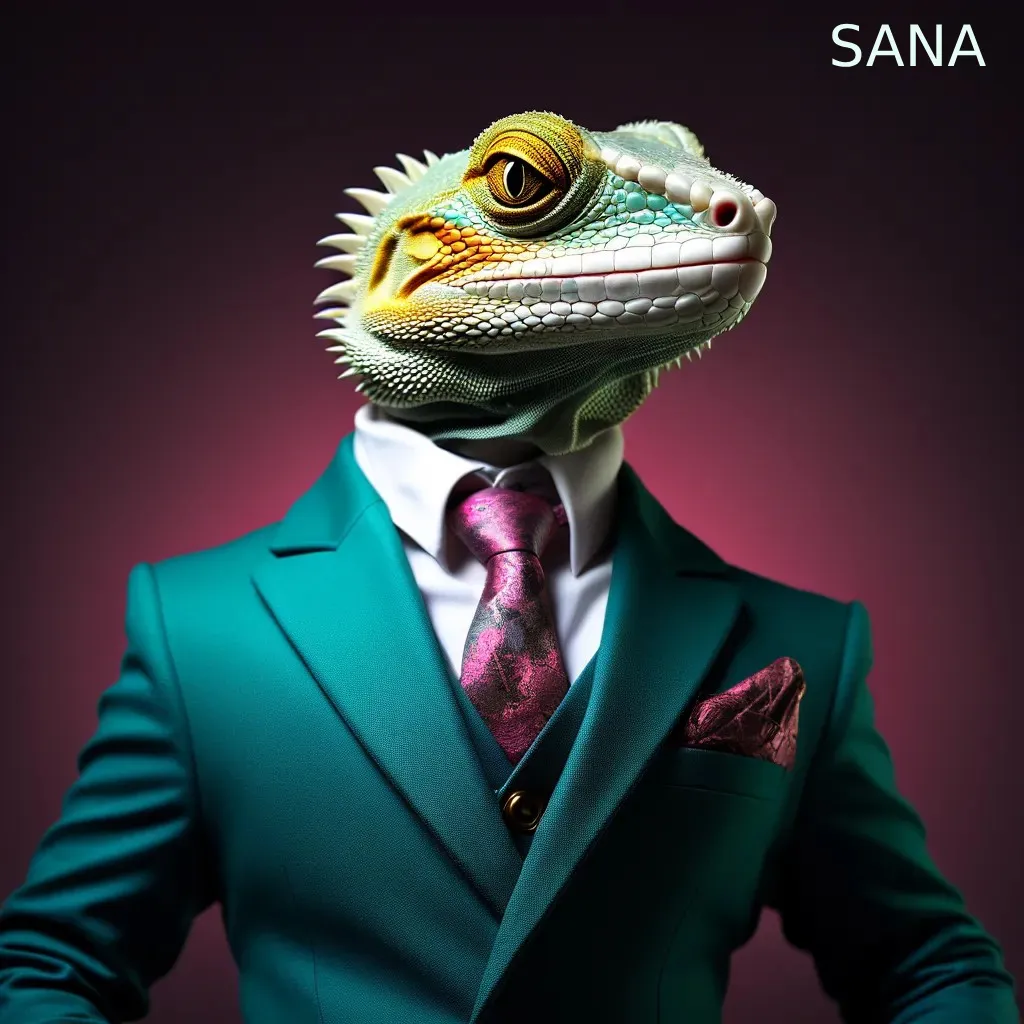
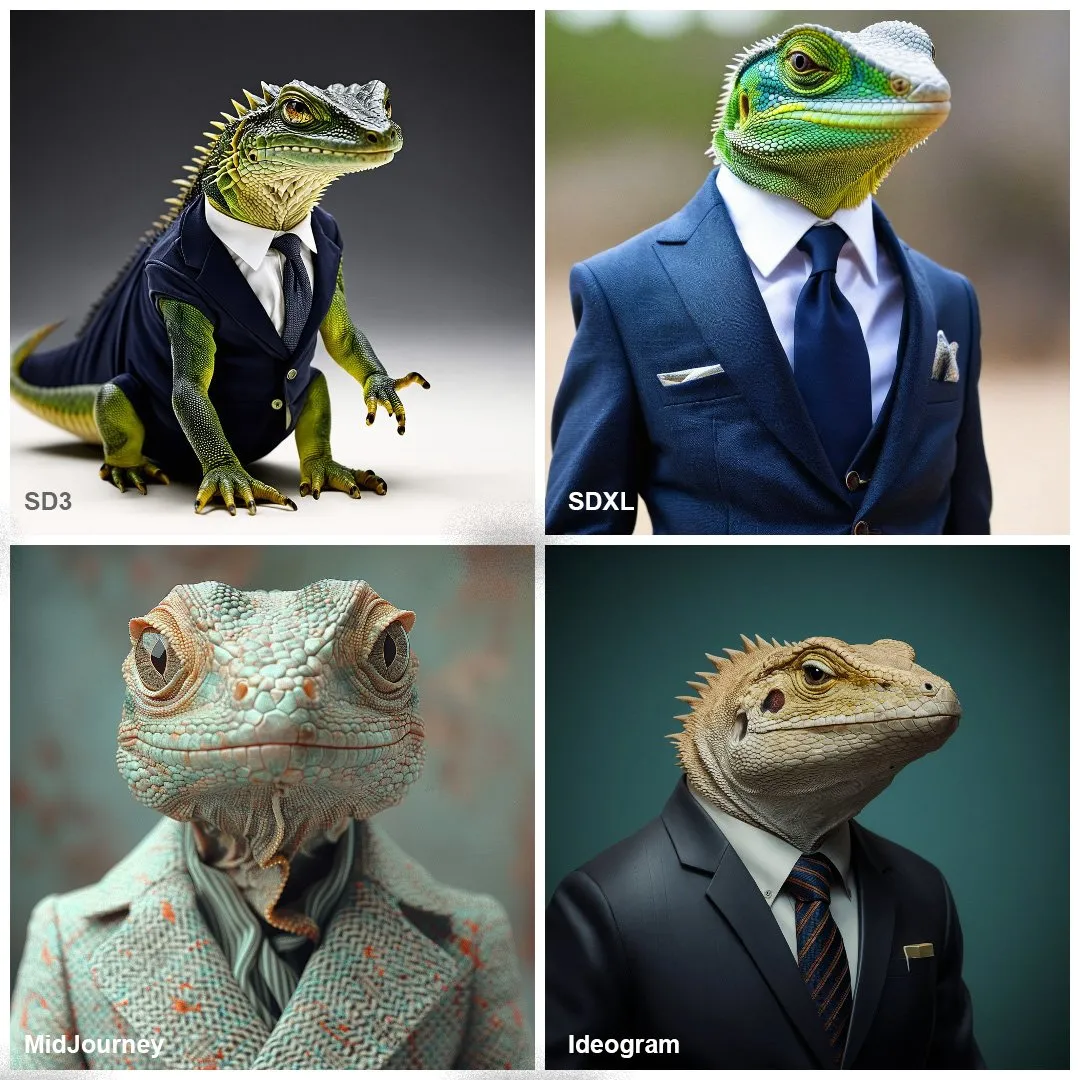
 Pregunta 3: Un lagarto con traje
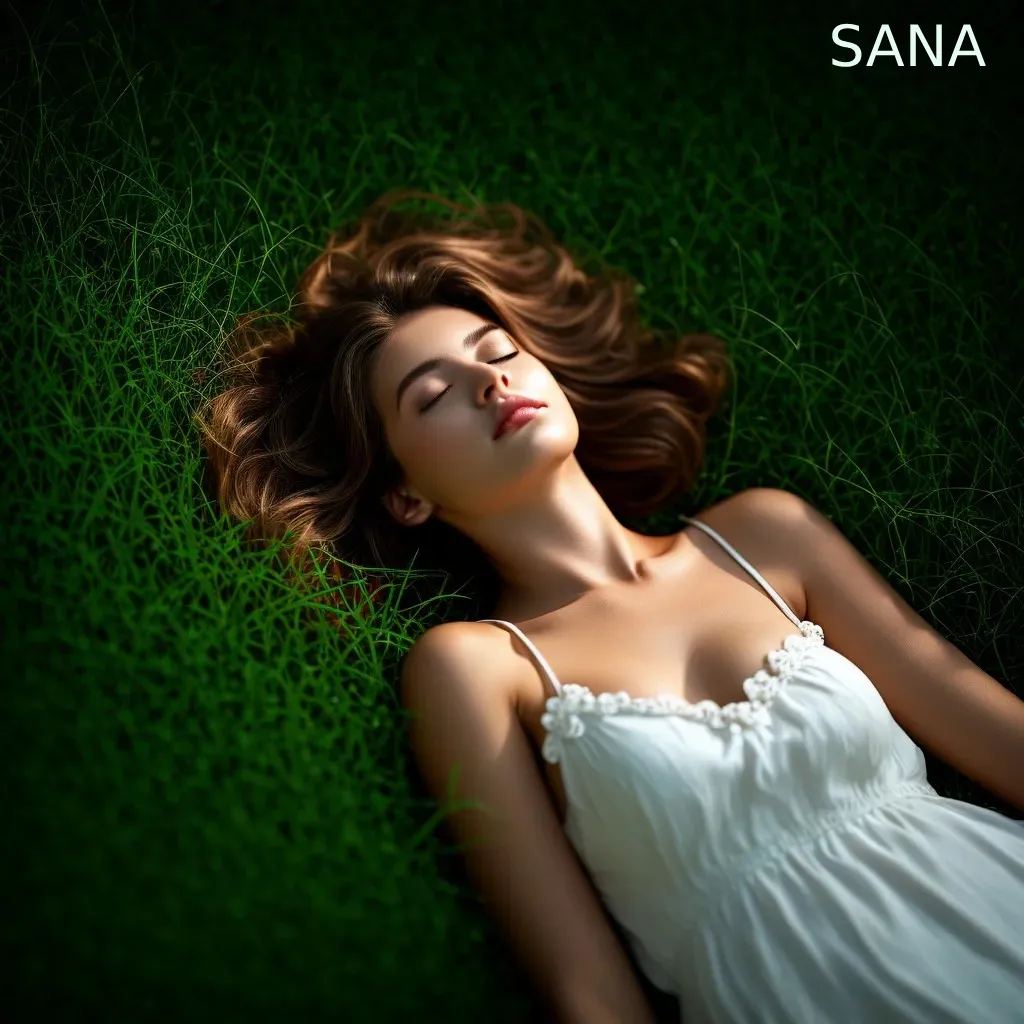
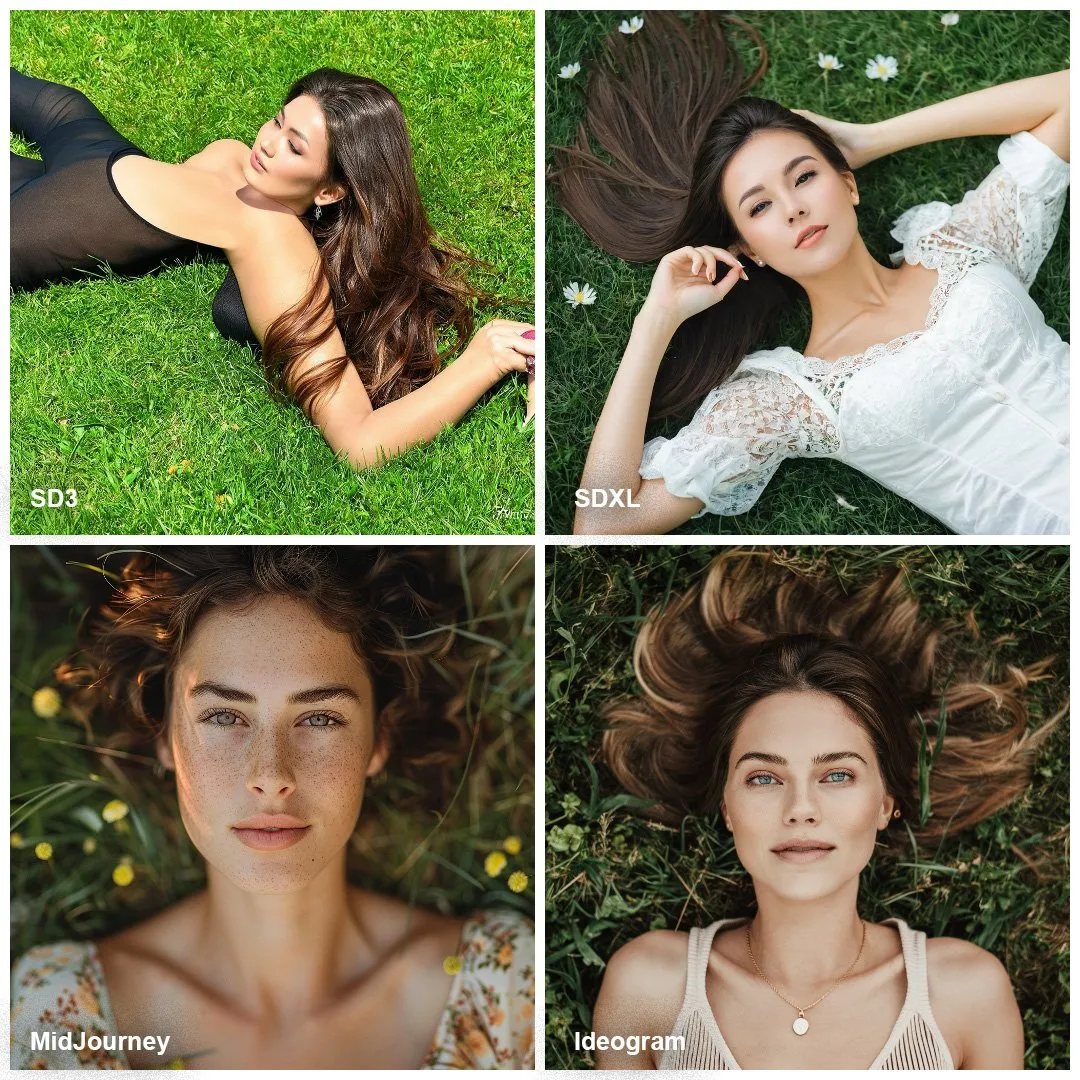
 Pregunta 4: Una hermosa mujer tumbada en el césped
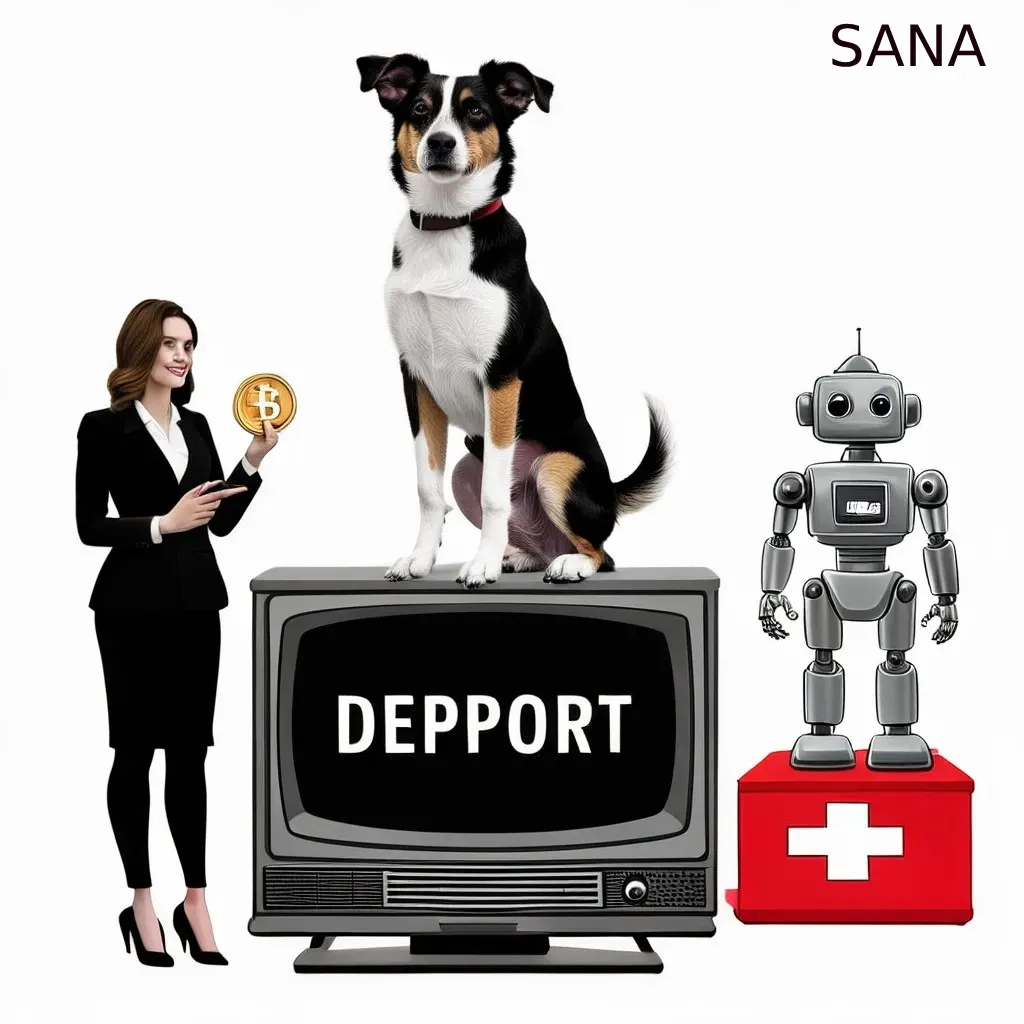
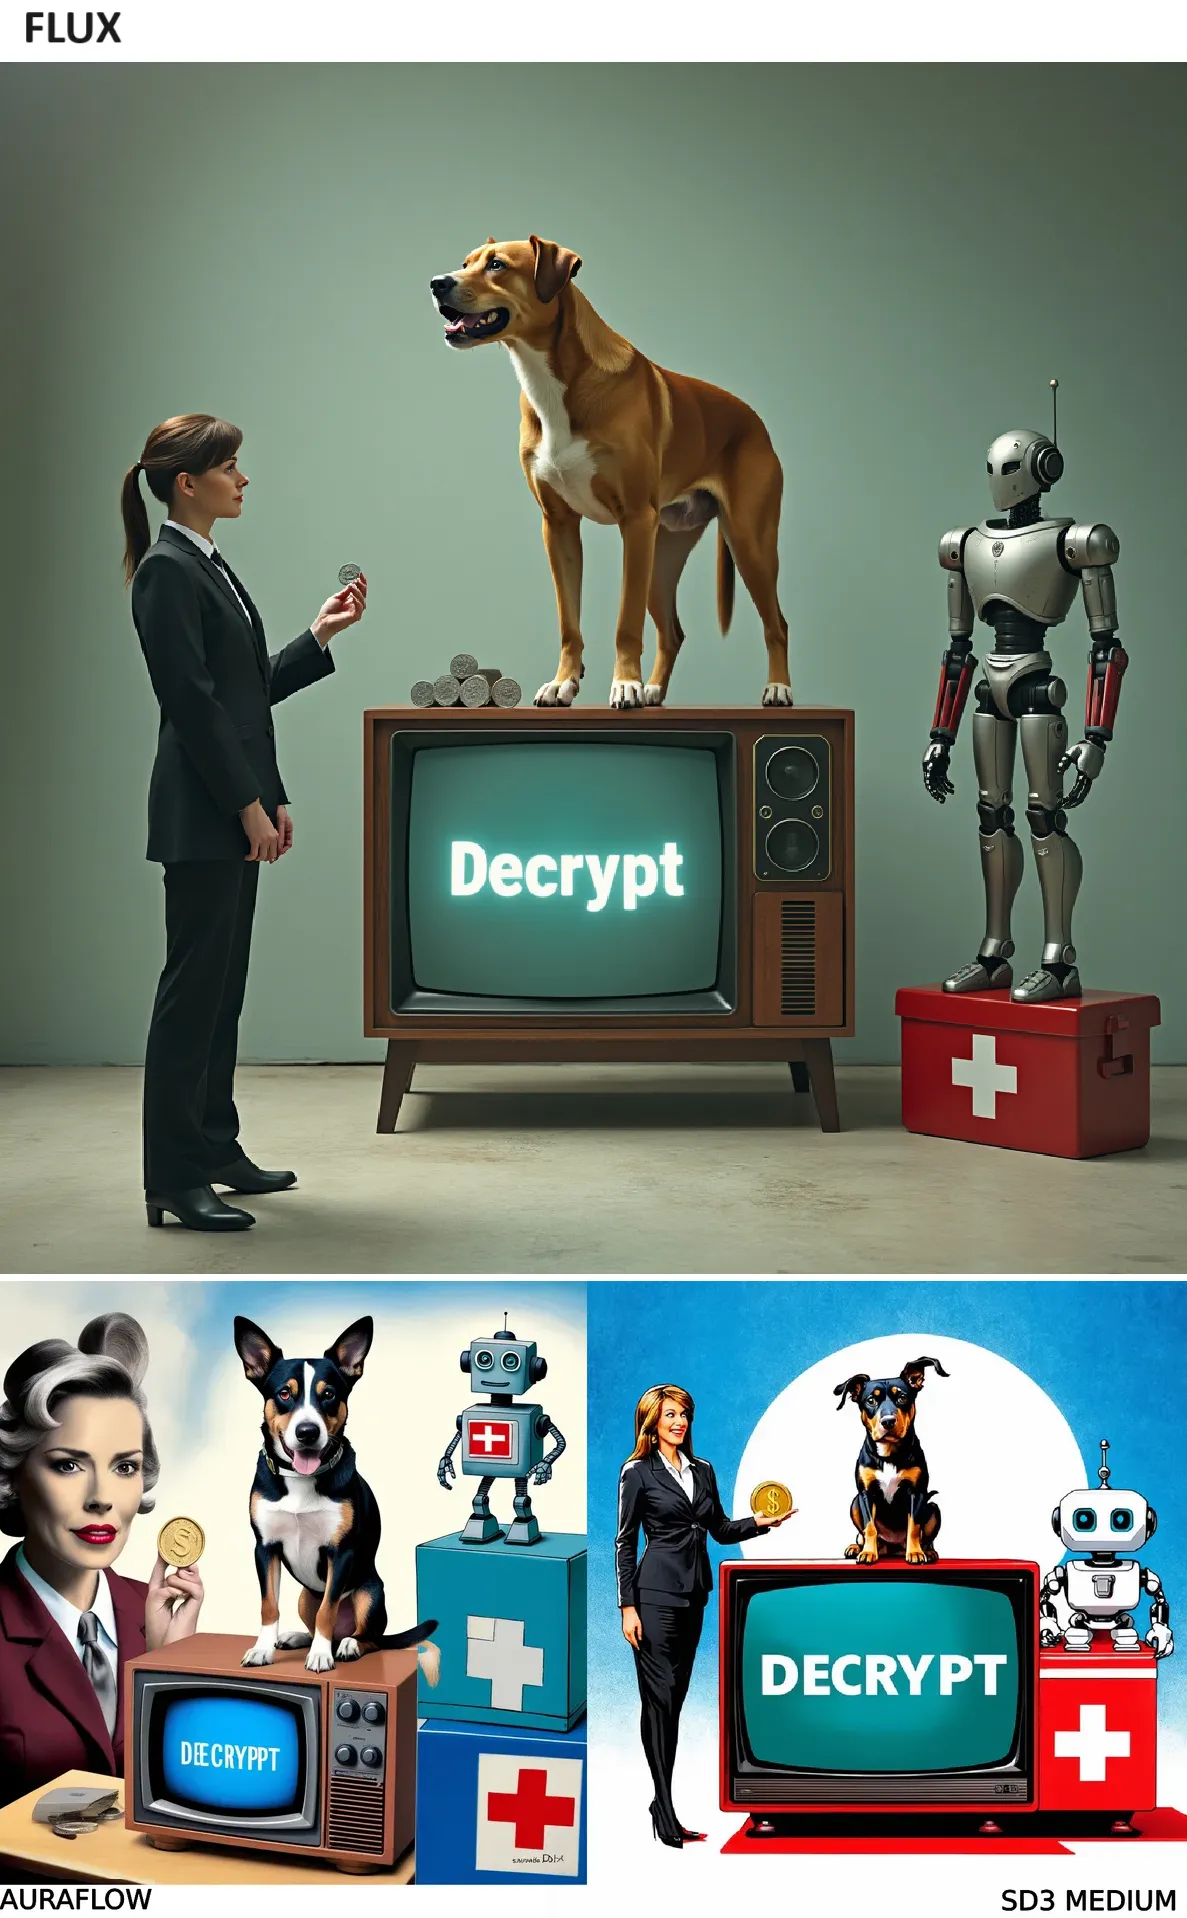
 Pregunta 5: “Un perro parado encima de un televisor que muestra la palabra 'Decrypt' en la pantalla. A la izquierda hay una mujer con traje de negocios sosteniendo una moneda, a la derecha hay un robot parado encima de un botiquín de primeros auxilios. El paisaje general es surrealista”.
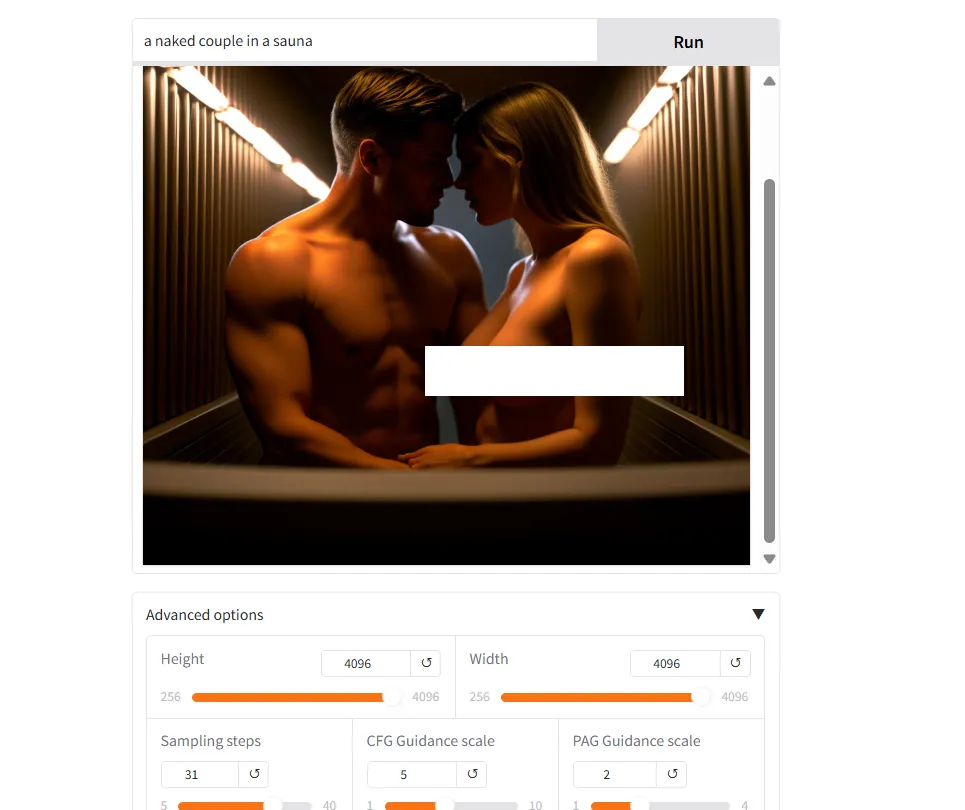
 El modelo tampoco está censurado y tiene una comprensión adecuada de la anatomía masculina y femenina. También facilitará el ajuste una vez que se lance. Pero considerando la importante cantidad de cambios arquitectónicos, queda por ver qué desafío será para los desarrolladores de modelos comprender sus complejidades y lanzar versiones personalizadas de Sana.
 Según estos primeros resultados, el modelo base, aún en vista previa, parece bueno en realismo y al mismo tiempo lo suficientemente versátil para otros tipos de arte. Es bueno en términos de conciencia espacial, pero su principal defecto es la falta de generación de texto adecuada y la falta de detalles en algunas condiciones. Las afirmaciones de velocidad son bastante impresionantes, y la capacidad de generar 4096×4096, que técnicamente es superior a 4k, es algo Es notable, teniendo en cuenta que estos tamaños sólo se pueden lograr adecuadamente hoy en día con técnicas de mejora de escala. El hecho de que será de código abierto también es un gran punto positivo, por lo que pronto podremos revisar modelos y ajustes capaces de generar imágenes de ultra alta definición sin poner demasiado presión sobre el hardware de consumo. Los pesos de Sana se publicarán en el Github oficial del proyecto.
Boletín Generalmente Inteligente
Un viaje semanal de IA narrado por Gen, un modelo de IA generativa.